
用 scikit-learn 做价格预测:540 条数据到模型
数据看板上画完历史价格曲线之后,我想再往前一步:能不能预测未来几个月的价格走势。
这个需求正好把我课上学到的东西用上了——线性回归。这篇文章讲怎么用 scikit-learn 把它落地,以及这个做法有哪些我没能解决的局限。
目标
需求很明确:给一个农产品,根据它过去的价格记录,预测未来 3 个月的零售价。
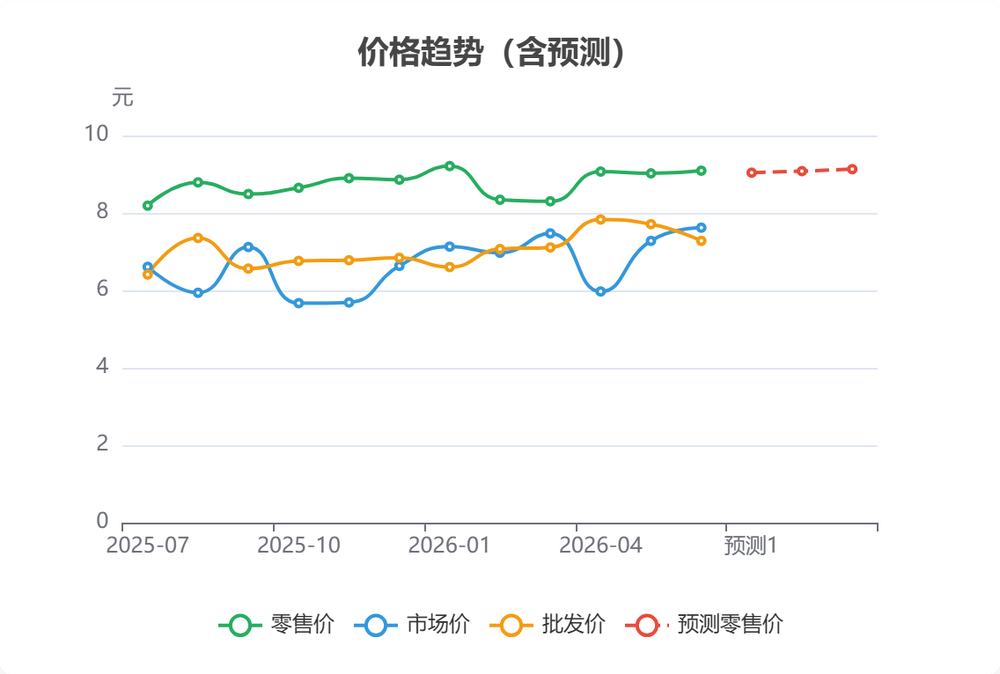
最终效果是价格走势图上那条红色虚线——实线是真实历史数据,虚线是模型算出来的预测值,两者的衔接处正好落在当下。
数据从哪来
价格数据存在 prices 表里:
class Price(models.Model):
    product = models.ForeignKey('products.Product', on_delete=models.CASCADE,
                                 related_name='prices', db_column='product_id')
    record_date = models.DateField('记录日期')
    market_price = models.DecimalField('市场价格', max_digits=10, decimal_places=2,
                                        null=True, blank=True)
    wholesale_price = models.DecimalField('批发价格', max_digits=10, decimal_places=2,
                                           null=True, blank=True)
    retail_price = models.DecimalField('零售价格', max_digits=10, decimal_places=2,
                                        null=True, blank=True)

    class Meta:
        db_table = 'prices'
        ordering = ['-record_date']
        unique_together = ['product', 'record_date']
三个价格字段都是可空的,因为实际业务中不一定每次都能拿到全部三种价格。
unique_together = ['product', 'record_date'] 这条约束很重要——同一个产品在同一天只能有一条价格记录。它保证了数据不会重复,也意味着每个产品的价格记录天然构成一条按时间排列的序列。
种子数据生成了 30 个产品 × 18 个月,共 540 条价格记录。
模型:线性回归
完整代码只有一个函数:
import numpy as np
from sklearn.linear_model import LinearRegression
from .models import Price


def predict_price(product_id, future_months=3):
    prices = Price.objects.filter(
        product_id=product_id, retail_price__isnull=False
    ).order_by('record_date')[:12]

    if len(prices) < 6:
        return None

    y = np.array([float(p.retail_price) for p in prices]).reshape(-1, 1)
    x = np.array(range(1, len(y) + 1)).reshape(-1, 1)

    model = LinearRegression()
    model.fit(x, y)

    future_x = np.array(range(len(y) + 1, len(y) + future_months + 1)).reshape(-1, 1)
    future_y = model.predict(future_x)

    return {
        'months': ['预测' + str(i + 1) for i in range(future_months)],
        'values': [round(float(v[0]), 2) for v in future_y],
        'slope': round(float(model.coef_[0][0]), 4),
        'intercept': round(float(model.intercept_[0]), 2),
    }
逐段拆解。
1. 取数据
prices = Price.objects.filter(
    product_id=product_id, retail_price__isnull=False
).order_by('record_date')[:12]
retail_price__isnull=False 过滤掉没有零售价的记录——模型要预测的就是零售价,缺这个字段的数据没法用。
order_by('record_date') 按日期升序,保证后面拿到的序列是时间正序的。
2. 数据量下限
if len(prices) < 6:
    return None
少于 6 条记录直接返回 None,不做预测。
这不是偷懒。用两三个点拟合一条直线,任何波动都会让斜率剧烈变化,算出来的结果毫无参考价值。与其给一个看起来很精确但实际胡说八道的数字,不如明确表示"数据不足"。
前端会据此决定不画那条虚线——图还是正常显示,只是没有预测部分。
3. 构造训练数据
y = np.array([float(p.retail_price) for p in prices]).reshape(-1, 1)
x = np.array(range(1, len(y) + 1)).reshape(-1, 1)
y 是价格,x 是自变量。
scikit-learn 要求输入是二维数组——每行一个样本,每列一个特征。所以即使只有一个特征,也要用 .reshape(-1, 1) 把一维数组变成列向量。-1 表示"这一维让 numpy 自己算",1 表示一列。
忘记 reshape 会报 Expected 2D array, got 1D array instead,这是初学 scikit-learn 最常见的错误。
4. 拟合与预测
model = LinearRegression()
model.fit(x, y)

future_x = np.array(range(len(y) + 1, len(y) + future_months + 1)).reshape(-1, 1)
future_y = model.predict(future_x)
fit() 算出一条最贴近所有点的直线,predict() 把未来的 x 代进去求 y。
future_x 的构造是 range(len(y) + 1, len(y) + future_months + 1)。假设有 12 条历史数据、预测 3 个月,那就是 range(13, 16),即 13、14、15——正好接在历史数据 1~12 之后。
5. 返回斜率
'slope': round(float(model.coef_[0][0]), 4),
'intercept': round(float(model.intercept_[0]), 2),
除了预测值,还把模型的斜率和截距一起返回。
斜率代表趋势:正数表示价格在涨,负数表示在跌,绝对值越大涨跌越快。这个数字比三个预测点更有信息量——它直接回答了"这个产品的价格是在涨还是在跌"。
前端:怎么把预测接到历史曲线后面
预测数据只有 3 个点,历史数据有 12 个点,两者要在同一张图上显示。关键在于用 null 补齐长度:
const [trendRes, predRes] = await Promise.all([
    fetch('/admin/dashboard/api/price-trend?product_id=' + productId),
    fetch('/admin/dashboard/api/price-predict?product_id=' + productId)
]);
const {data} = await trendRes.json();
const predData = await predRes.json();

const predValues = predData.data
    ? [...new Array(data.dates.length).fill(null), ...predData.data.values]
    : [];
new Array(data.dates.length).fill(null) 造出一个长度为 12、全是 null 的数组,再用展开运算符把 3 个预测值接在后面,得到 [null×12, 预测1, 预测2, 预测3]——长度和历史数据对齐了。
ECharts 遇到 null 会跳过该点不绘制,所以虚线会从历史数据的末尾自然开始。
然后再根据 predData.data 是否存在,决定要不要加这条虚线:
if (predData.data) {
    seriesConfig.push({
        name: '预测零售价', type: 'line', data: predValues, smooth: true,
        lineStyle: {type: 'dashed', color: '#e74c3c', width: 2},
        itemStyle: {color: '#e74c3c'},
    });
}
后端返回 None(数据不足)时,predData.data 是 null,这条线就不加。前后端通过"有没有数据"这一个信号完成协作,不需要额外的状态字段。
四个问题,以及各自的解法
做到这里功能是完整的。但写完之后我把代码又读了一遍,发现四个问题,从轻到重分别是。
问题一:取的是最早的 12 条,不是最近的
问题在哪。
.order_by('record_date')[:12]order_by('record_date') 是升序排列,[:12] 取的是前 12 条——也就是最早的那 12 条记录。
每个产品有 18 个月的数据,这个切片实际丢掉了最近的 6 个月。模型是在用一年前的数据预测现在。
这个 bug 在图上完全看不出来——预测线接在历史数据末尾,衔接自然,看着毫无破绽。它是我一行行读代码时才发现的。
怎么改。先按日期倒序取最近 12 条,再反转成正序:
prices = list(Price.objects.filter(
    product_id=product_id, retail_price__isnull=False
).order_by('-record_date')[:12])
prices.reverse()
为什么不能直接 order_by('record_date') 再取最后 12 条?因为在 Django 里对 QuerySet 用负索引切片([-12:])会报错——它不支持反向切片。所以只能"倒序取前 12 + 反转"这两步。
问题二:自变量用序号,忽略了真实的时间间隔
问题在哪。
x = np.array(range(1, len(y) + 1)).reshape(-1, 1)自变量是 1, 2, 3, 4...,而不是真实日期。这等于假设相邻两条记录之间间隔相等。
本项目的种子数据是每月一条,间隔确实均匀,所以没暴露问题。但真实数据不可能这么规整——比如某个产品前半年按月记录,后半年因为忙只在年底补了两条,那"第 7 个点"和"第 8 个点"之间实际隔了 8 个月和 1 个月,模型却当成等距处理,斜率必然算错。
怎么改。把 x 换成「距离第一条记录的天数」:
from datetime import date

prices = list(Price.objects.filter(
    product_id=product_id, retail_price__isnull=False
).order_by('-record_date')[:12])
prices.reverse()

if len(prices) < 6:
    return None

# 以第一条记录的日期为原点,算每条记录距它多少天
base = prices[0].record_date
x = np.array([(p.record_date - base).days for p in prices]).reshape(-1, 1)
y = np.array([float(p.retail_price) for p in prices]).reshape(-1, 1)

model = LinearRegression()
model.fit(x, y)

# 预测未来 3 个月:按 30 天一个月往后推
last_day = x[-1][0]
future_x = np.array([[last_day + 30 * i] for i in range(1, future_months + 1)])
future_y = model.predict(future_x)改动很小,但含义完全不同了:x 轴从"第几条"变成了"第几天"。这样无论记录间隔多不均匀,模型看到的距离都是真实的。
注意预测点的构造方式也跟着变了:不再是 len(y)+1 这样的序号,而是在最后一个真实日期上加 30 天、60 天、90 天。
这个改动还带来一个额外好处:预测值可以对应到具体日期,而不只是"预测 1、预测 2、预测 3"。前端可以把 x 轴标签换成真实月份,读起来更直观。
问题三:没有评估模型好坏
问题在哪。整个流程里没有任何一步在检验模型准不准。只要数据够 6 条,就无条件给出一组预测值——没有任何可信度信息。
这比看起来更严重。一个不准的预测比没有预测更糟糕,因为它带着"这是模型算出来的"的权威感,容易让人当真。
怎么改。用留出法划分训练集和测试集:拿前 9 条训练,用后 3 条验证。
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score

def evaluate(product_id, test_size=3):
    prices = list(Price.objects.filter(
        product_id=product_id, retail_price__isnull=False
    ).order_by('-record_date')[:12])
    prices.reverse()

    if len(prices) < test_size + 3:     # 训练至少 3 条,否则不评
        return None

    base = prices[0].record_date
    xs = np.array([(p.record_date - base).days for p in prices]).reshape(-1, 1)
    ys = np.array([float(p.retail_price) for p in prices]).reshape(-1, 1)

    # 切分:前段训练,后段当"未来"来验证
    x_train, x_test = xs[:-test_size], xs[-test_size:]
    y_train, y_test = ys[:-test_size], ys[-test_size:]

    model = LinearRegression()
    model.fit(x_train, y_train)
    y_pred = model.predict(x_test)

    return {
        'mae':  round(float(mean_absolute_error(y_test, y_pred)), 3),
        'rmse': round(float(np.sqrt(mean_squared_error(y_test, y_pred))), 3),
        'r2':   round(float(r2_score(y_test, y_pred)), 3),
        'actual':    [round(float(v), 2) for v in y_test.flatten()],
        'predicted': [round(float(v), 2) for v in y_pred.flatten()],
    }
三个指标各有各的用处:
| 指标 | 含义 | 怎么读 |
|---|---|---|
| MAE 平均绝对误差 | 预测值和真实值平均差多少 | 单位就是"元",最直观。MAE = 0.35 表示平均每次预测差三毛五 |
| RMSE 均方根误差 | 和 MAE 类似,但对大误差惩罚更重 | 如果 RMSE 明显大于 MAE,说明存在个别偏差很大的点 |
| R² 决定系数 | 模型解释了数据多少的变异 | 越接近 1 越好;接近 0 或负数说明模型还不如直接取平均值 |
最后一条尤其重要。如果 R² 是负的,说明这个线性模型对这批数据的解释力还不如"直接用历史均值"——那就该老老实实不用模型,而不是硬给一条线。
拿到这些数字之后,就可以在返回结果里带上可信度:
result = predict_price(product_id)
metric = evaluate(product_id)

if result and metric:
    result['accuracy'] = {
        'mae': metric['mae'],
        # 简单判断:平均误差小于 1 元认为可信
        'reliable': metric['mae'] < 1.0,
    }
前端就能据此决定要不要把预测线画成虚线、要不要加一句"预测仅供参考"。
问题四:线性假设本身可能不成立
问题在哪。线性回归假设价格按固定速率变化。但真实农产品价格有明显季节性——大闸蟹秋天上市时便宜,春节前后贵。
用一条直线拟合带季节性的数据,得到的是"平均趋势",所有周期特征都被抹平了。预测时如果正好跨越一个价格高峰,模型完全预测不到。
怎么改。这一条最麻烦,没有一行代码能解决。分三个层次:
先看清楚数据长什么样。画一条历史曲线,如果肉眼能看到明显的周期性起伏,那线性模型从根上就不合适。这是零成本的一步——先看图,再选模型。
其次可以试试"线性 + 季节项"。用月份序号做个哑变量(一月、二月……),把季节性作为额外特征喂进去。改动不大,scikit-learn 用 OneHotEncoder 就能做。
最后才是换模型。如果季节性很强,应该用专门的时间序列方法,比如把序列拆成"趋势 + 季节 + 残差"三部分分别建模,或者用 ARIMA 这类能显式处理季节性的模型。
不过说实话,这个项目的数据量(18 个月)根本不够支撑复杂模型。时间序列方法通常需要至少两三个完整周期才能识别出季节规律,18 个月只够识别一轮。所以在这一步之前,更该做的是先把数据攒够。
选择模型的依据应该是数据本身,而不是模型的先进程度。数据只有 18 个点的时候,简单模型的稳健性反而更值钱。
小结
这个功能的核心代码不到 30 行,但它是整个项目里我最满意的一部分——因为它是唯一一个"从数据里得出新信息"的功能,而不是简单的增删改查和展示。
上面四个问题,性质各不相同:
| 问题 | 性质 | 改动量 |
|---|---|---|
| 取最早 12 条 | 纯粹的 bug | 2 行 |
| 自变量用序号 | 简化导致的不严谨 | 10 行左右 |
| 没有模型评估 | 流程缺失 | 新增一个函数 |
| 线性假设 | 方法本身的局限 | 需要重新选模型 |
它们让我意识到一件事:机器学习的坑和普通编程的坑不一样。
普通编程的 bug 会报错、会崩溃、会有明显的异常表现。而这四个问题里,只有第一个算 bug——但它在图上看着完全正常,预测线接得好好的。另外三个甚至连"错"都算不上,代码能跑、结果也有,只是结果的可信度是未知的。
这才是最危险的地方:一个不报错的错误结论。
如果只是写 CRUD,代码跑通了基本就是对的。但涉及数据分析和建模,跑通只说明没有语法错误——结果对不对,需要另外一套方法去验证(切分测试集、算误差指标、和基线比较)。
这也是我这次最大的收获:学会用指标去质疑自己的模型,而不只是看到"有输出"就认为做完了。
暂无评论