
数据标准化与图表选型:8 张图的选型逻辑
城市分析那个项目一共出了 8 张图。做完之后回头看,我觉得比"会写 matplotlib 代码"更值得记的,是每张图为什么选这个类型——同样一组数据,画成箱线图和画成柱状图,能传达的信息完全不同。
这篇笔记分两部分:先说数据处理里一个绕不开的步骤(标准化),再说 8 张图各自的选型理由。
标准化:为什么要把数据"变成同一个尺度"
问题从哪来
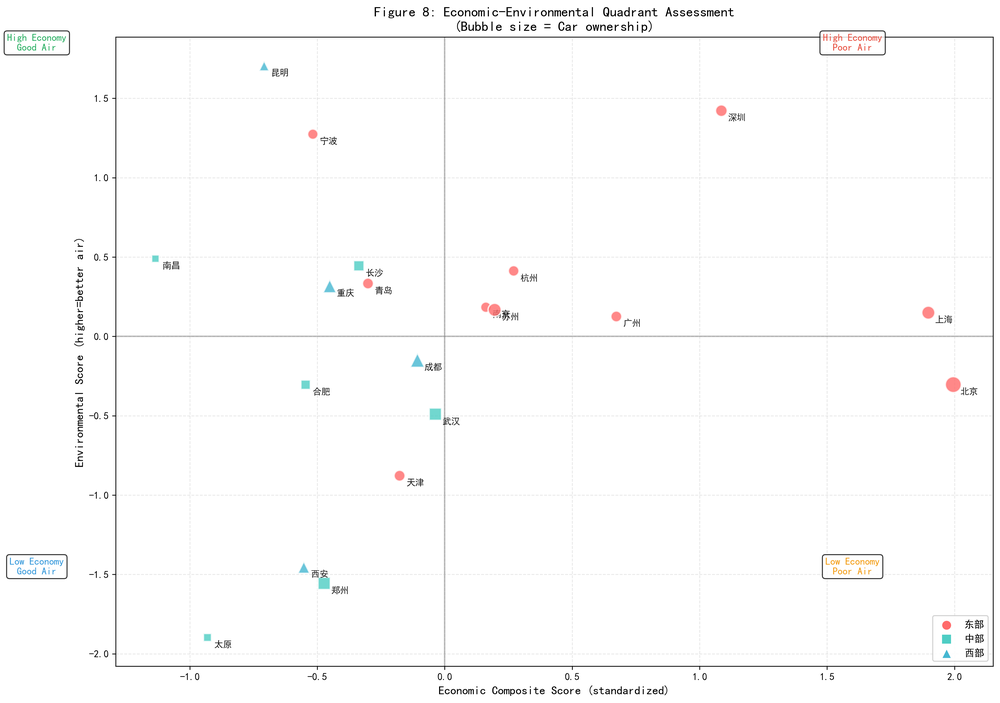
项目里有一张"经济-环境四象限图",要回答的问题是:哪些城市经济发展好、空气也好?
听起来简单——拿经济指标和环境指标各算一个综合得分,然后在坐标系里定位就行了。
但经济指标有四个:GDP(亿元)、人均 GDP(元)、第三产业占比(%)、地方一般公共预算收入(亿元)。它们的量纲完全不同:
- GDP 动辄几万(单位:亿元)
- 人均 GDP 也是几万(单位:元)
- 第三产业占比在 50-85 之间(%)
如果直接把四个数加起来,GDP 这一项会因为数值大而完全主导结果,其他三个指标等于没起作用。这不是分析,是"谁的数大谁说了算"。
解法:Z-score 标准化
from sklearn.preprocessing import StandardScaler

ecols = ['GDP_亿元', '人均GDP_元', '第三产业占比_pct', '地方一般公共预算收入_亿元']
envcols = ['AQI年均值', 'PM2_5年均值_ugm3', 'PM10年均值_ugm3', 'NO2年均值_ugm3']

sc = StandardScaler()
dp = df.copy()
dp['es'] = sc.fit_transform(dp[ecols]).mean(axis=1)
dp['ev'] = -sc.fit_transform(dp[envcols]).mean(axis=1)
StandardScaler 做的是 Z-score 标准化,公式是:
z = (x - 均值) / 标准差转换之后,每个指标都变成了"这个城市比平均值高多少个标准差"。
这个变换解决了两个问题:
一是量纲统一。不管原始单位是亿元还是百分比,标准化后都是无量纲的 z 值,可以直接相加。
二是可比性。z = +1 表示"高于平均一个标准差",不管是哪个指标含义都一致。所以四个指标的 z 值求平均,得到的"综合得分"是有意义的。
一个容易看漏的细节:环境得分取了负号
dp['ev'] = -sc.fit_transform(dp[envcols]).mean(axis=1)
↑ 注意这个负号为什么要取负?因为环境指标越小越好——AQI 低、PM2.5 低才是空气好。
但标准化之后,AQI 低的城市 z 值是负数。如果直接平均,空气好的城市反而得到低分,和"分数越高越好"的直觉相反,画在四象限图上会全部错位。
取负号之后,语义统一成了"分数越高 = 空气越好",和经济得分的方向一致。这样画出来的象限图才能直接解读:右上角是"经济好+空气好",左下角是"经济差+空气差"。
这是个很小但很关键的改动。凡是把多个指标合成一个得分时,一定要先确认所有指标的方向一致——有的越大越好,有的越小越好,混在一起算平均是错的。
另一种做法:min-max 归一化
同一项目的雷达图用了另一套方法:
for c in rmet:
    mn, mx = dr[c].min(), dr[c].max()
    if c in ['AQI年均值', 'PM2_5年均值_ugm3']:
        dr[c] = 1 - (dr[c]-mn)/(mx-mn)   # 越小越好的指标反向
    else:
        dr[c] = (dr[c]-mn)/(mx-mn)
min-max 把数据压缩到 [0, 1] 区间,公式是 (x - 最小值) / (最大值 - 最小值)。
它和 Z-score 的区别:
| Z-score | min-max | |
|---|---|---|
| 结果范围 | 无固定范围,通常 -3 到 3 | 固定 [0, 1] |
| 受离群值影响 | 较小 | 大(一个极端值会压缩其他所有值) |
| 适用场景 | 需要保留"偏离均值程度"的信息 | 需要固定区间(如雷达图的轴) |
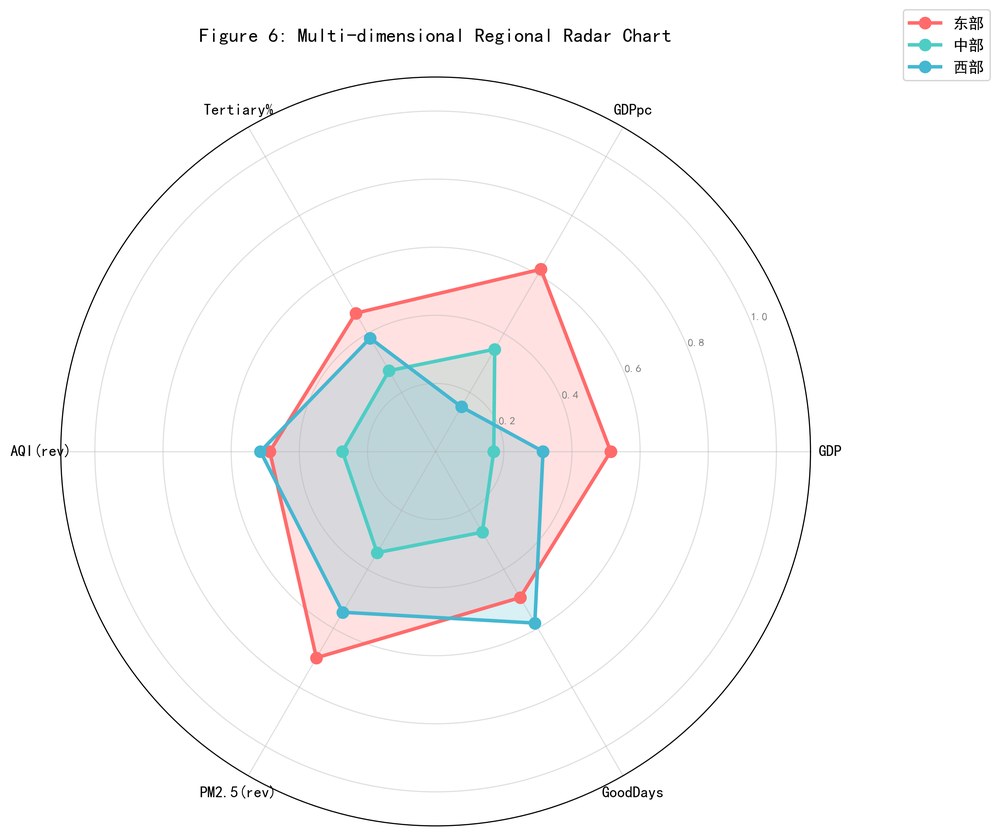
雷达图用 min-max 是因为它的每个轴需要统一的取值范围。注意这里也做了方向统一——AQI 和 PM2.5 用 1 - (x-min)/(max-min) 反向,让"越靠外越好"对六个维度都成立。
8 张图的选型逻辑
下面按类型归类,说每张图回答什么问题。
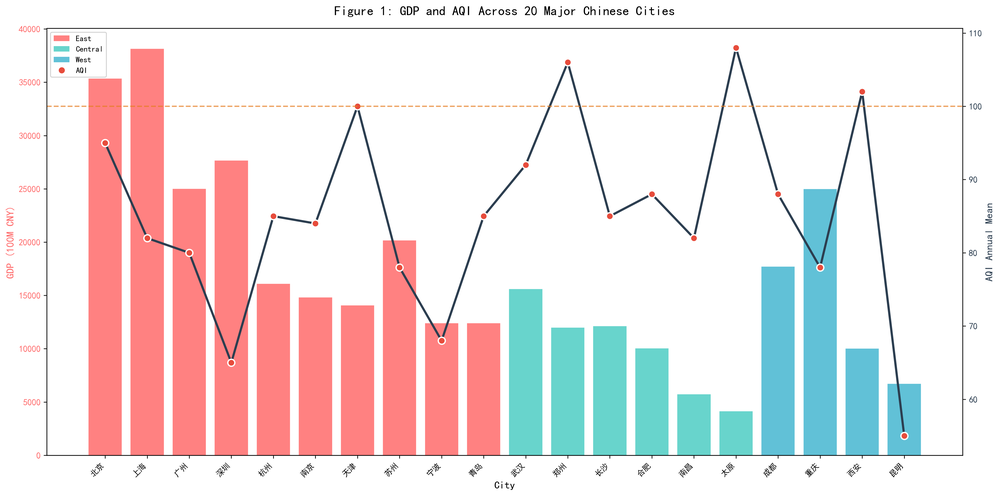
双轴组合图(Fig 1)——两种量纲对比
问题:GDP 和 AQI 在 20 个城市上的分布,有没有同步关系?
GDP 单位是亿元(数值上万),AQI 是 0-150 的无量纲指数。画在同一个 Y 轴上,AQI 会被压成一条贴着底的线,什么都看不出来。
解法是用双 Y 轴:
fig, ax1 = plt.subplots(figsize=(16, 8))
ax1.bar(range(len(df)), df['GDP_亿元'], color=[RC[r] for r in df['区域']])

ax2 = ax1.twinx()                              # 共享 X 轴,独立 Y 轴
ax2.plot(range(len(df)), df['AQI年均值'], 'o-', color='#2C3E50', linewidth=2.5)
ax2.axhline(y=100, color='#E67E22', linestyle='--', linewidth=1.5)
ax1.twinx() 是关键——它创建一个共享 X 轴但独立 Y 轴的新坐标系。柱状图用左轴,折线用右轴。
另外 ax2.axhline(y=100) 画了一条 AQI = 100 的水平参考线。这条线很重要:没有参照系的图表只是装饰,有了"100 是良与轻度污染的分界"这个基准,读者才知道哪些城市超标了。
散点图 + 回归线(Fig 2、Fig 5)——看两个变量的关系
问题:人均 GDP 和 PM2.5 之间是什么关系?
散点图是这个问题的标准答案——每个点是一个城市,横轴一个变量、纵轴另一个,关系一目了然。
sl, ic, rv, pv, _ = stats.linregress(df['人均GDP_元'], df['PM2_5年均值_ugm3'])
xr = np.linspace(df['人均GDP_元'].min()*0.9, df['人均GDP_元'].max()*1.05, 100)
ax.plot(xr, sl*xr+ic, '--', color='#2C3E50', linewidth=2,
        label=f'OLS (r={rv:.3f}, p={pv:.4f})')
几个细节:
回归线只画在数据范围内。np.linspace 的起止点是从数据的最小/最大值稍作外扩得到的,不是随便画一条贯穿全图的直线——把回归线延伸到没有数据的地方是常见的误导。
相关系数和 p 值直接标在图上,用圆角文本框:
ax.text(0.05, 0.95, f'r = {rv:.4f}\nR² = {rv**2:.3f}\np = {pv:.4f}',
        transform=ax.transAxes, fontsize=11, verticalalignment='top',
        bbox=dict(boxstyle='round', facecolor='wheat', alpha=0.8))
transform=ax.transAxes 是个实用技巧——加了它,坐标 (0.05, 0.95) 指的是"轴的 5% 和 95% 位置",而不是数据坐标。这样文本框永远固定在左上角,不管数据范围怎么变都不会跑到图外。
气泡图(Fig 5)——三个维度
问题:第三产业占比和 PM2.5 有关系吗?汽车保有量在其中扮演什么角色?
散点图只能表达两个维度。第三个维度用气泡大小来编码:
s=np.sqrt(row['汽车保有量_万辆'])*18注意这里的 np.sqrt——不是可有可无的。
人眼判断圆的大小是按面积来的,而 matplotlib 的 s 参数控制的是面积。如果直接用数值当面积,那么"数值 100"的气泡面积是"数值 10"的 10 倍,人眼会觉得大了 10 倍;但实际上半径只大了 3.16 倍,视觉上是失真的。
开平方之后,数值和半径成正比,面积和数值的平方成正比——视觉上更接近"数值翻倍,看着大一倍"。这是气泡图的通用规范。
箱线图(Fig 4)——看分布而不是均值
问题:东部/中部/西部的 PM2.5 分布有差异吗?
如果只画柱状图对比区域均值,会丢掉一个关键信息:组内差异有多大。如果某组里既有极好也有极差的,均值掩盖了这种离散。
箱线图能同时显示中位数、四分位数和离群值:
ax.boxplot([d], positions=[i], widths=0.6, patch_artist=True,
           boxprops=dict(facecolor=RC[r], alpha=0.7),
           medianprops=dict(color='white', linewidth=2),
           whiskerprops=dict(linewidth=1.5), capprops=dict(linewidth=1.5))

# 叠加抖动散点,显示每组的实际样本
jt = np.random.normal(0, 0.05, size=len(d))
ax.scatter(np.ones(len(d))*i+jt, d, alpha=0.6, s=60, c=RC[r],
edgecolors='white', linewidth=0.5, zorder=3)额外叠加抖动散点(jitter)是个好做法——箱线图会隐藏样本量。一组 3 个点和一组 30 个点,箱子的形状可能差不多,但可信度天差地别。np.random.normal(0, 0.05, ...) 是给每个点加一个横向的小扰动,让重叠的点能分开显示。
雷达图(Fig 6)——多维对比
问题:三个区域在 6 个维度上各有什么特点?
雷达图适合"多个对象 × 多个维度"的对比。但要注意两点:
一、维度不能太多。6 个左右是上限,再多会乱成一团。而且维度之间最好语义相近(这里是 3 个经济 + 3 个环境)。
二、必须先归一化。雷达图的每个轴是独立的,如果不归一化,GDP(上万)和第三产业占比(几十)画在同一个半径尺度上,占比那条线会缩在中心。
三、闭合处理。
angles = np.linspace(0, 2*np.pi, nv, endpoint=False).tolist() + [0]末尾那个 + [0] 是把第一个角度再接一次,让多边形的最后一条边闭合回起点。少了它,图形会缺一条边。
堆叠面积图(Fig 7)——构成与累积
问题:20 个城市的汽车保有量和主要污染物之间是什么关系?
用 fill_between 做两段堆叠:
ab.fill_between(xr7, 0, ds['PM2_5年均值_ugm3'], alpha=0.5, color='#E74C3C', label='PM2.5')
ab.fill_between(xr7, ds['PM2_5年均值_ugm3'],
                ds['PM2_5年均值_ugm3']+ds['NO2年均值_ugm3'],
                alpha=0.5, color='#3498DB', label='NO2')
第一层从 0 画到 PM2.5 的值;第二层从 PM2.5 画到 PM2.5 + NO2。关键在第二层的起点不是 0,而是第一层的终点——这样才能堆叠起来。
这张图还做了个处理:两个面板用同一套排序(df.sort_values('汽车保有量_万辆')),所以上下两图的城市是一一对应的。并且上图的 X 轴标签被清空了(at.set_xticklabels([])),避免重复标注。
这是组合图的一个通用技巧:多个子图共享同一维度时,用同一排序 + 只标一次轴标签,读者才能跨图对照。
热力图(Fig 3)——全变量关系一览
问题:15 个变量两两之间,哪些相关性强?
如果两两算相关系数打印成表格,是 15×15 = 225 个数,没法看。热力图用颜色编码,一眼就能扫出规律:
mask = np.triu(np.ones_like(cc, dtype=bool), k=1)
cmp = sns.diverging_palette(250, 15, s=75, l=40, n=15, center='light')

sns.heatmap(cc, mask=mask, cmap=cmp, center=0, annot=True, fmt='.2f',
            linewidths=0.8, vmin=-1, vmax=1, square=True)
三个处理值得说:
mask=np.triu(..., k=1) 遮掉上三角。相关矩阵是对称的,右上和左下重复。遮掉一半,视觉负担立刻减半。
center=0 + 发散色板。相关系数有正负之分,用发散色板(中间浅、两端深)才能让正相关和负相关一眼区分。如果用单色渐变,-0.8 和 +0.8 可能看起来差不多。
vmin=-1, vmax=1 固定色阶范围。不让 matplotlib 自动适配——固定范围才能保证同一份报告里多张热力图的颜色含义一致。
三张成品图
整理完这 8 张图,如果只能记三条,我会记这些。
选图先问"要回答什么问题"。对比构成用饼图或堆叠图,看关系用散点图,看分布用箱线图,看多维特点用雷达图。类型服从问题,不是服从"哪个好看"——同样一组数据,画成箱线图和画成柱状图,能传达的信息完全不同。
量纲不一致时必须先标准化。Z-score 适合需要保留"偏离程度"的场景,min-max 适合需要固定区间的场景。无论用哪种,都要先统一指标方向——越大越好的和越小越好的混在一起算平均,结果一定是错的。
细节决定图表能不能读。双轴图要有参考线,散点图要标注统计量,气泡图要对面积开方,热力图要遮掉重复的三角。这些不是装饰,是让图表从"能看"变成"能读懂"的必要条件。
不过这个项目里我自己也犯了个错。那张四象限图的气泡大小用的是汽车保有量,但汽车保有量本身就跟"经济"这个维度正相关——等于把经济因素算了两遍,可能夸大了某些城市的位置。换成人口密度、或者干脆去掉气泡,图会更干净。
这类问题做的时候完全没意识到,是后来重新看图才发现的。图表里的每个视觉通道(位置、大小、颜色)都在传递信息,用之前得先想清楚它和坐标轴是不是在讲同一件事。
暂无评论